確率変数・期待値・分散
Stage 2 — 第4章 | 統計検定2級チートシート 推定学習時間:55〜70分 | 難易度:★★★☆☆
この章で学ぶこと
確率分布を学ぶ前に、確率変数、確率質量関数、確率密度関数、分布関数、期待値、分散の意味を整理します。 ここが曖昧なまま分布名だけを覚えると、二項分布や正規分布の公式を使う場面で混乱します。
この章を終えると、こんなことができるようになります:
- 確率変数と実現値を区別できる
- 離散型と連続型の確率計算の違いを説明できる
- PMF、PDF、CDFの関係を整理できる
- 期待値と分散を定義から理解できる
- 期待値の線形性と分散のスケーリングを使える
- モーメント、歪度、尖度の位置づけを理解できる
1. 確率変数とは何か
確率変数とは、偶然の結果によって値が決まる変数です。
サイコロを1回振るとき、出る目を $X$ と書けば、$X$ は1から6のいずれかの値を取る確率変数です。実際に3が出たなら、3は実現値です。
| 記号 | 意味 |
|---|---|
| $X$ | 確率変数 |
| $x$ | 確率変数が取りうる具体的な値 |
| $P(X=x)$ | $X$ が $x$ になる確率 |
大文字の $X$ と小文字の $x$ を区別することは、統計検定2級でも重要です。
2. 離散型と連続型の違い
確率変数は、大きく離散型と連続型に分けられます。
| 種類 | 取りうる値 | 確率の求め方 | 例 |
|---|---|---|---|
| 離散型 | 数えられる値 | 確率を足す | 成功回数、来客数 |
| 連続型 | 連続した値 | 密度を積分する | 身長、重さ、時間 |
離散型では、特定の値を取る確率 $P(X=x)$ を直接扱えます。 連続型(確率密度関数を持つ場合)では、ある一点を取る確率は0で、区間の確率を面積として考えます。
なぜ連続型で一点の確率は0なのか
連続型では、確率は密度の面積で決まります。1点 $a$ は幅0の区間なので、その面積は0です。 式で書くと、どんな小さな $h>0$ についても
で、$h$ を0に近づけると右辺は0になります。
そのため、連続型では「ちょうどその値」ではなく「この範囲に入る確率」を考えます。確率密度関数の高さは確率そのものではなく、面積を作るための密度です。
関連教材(青の統計学)
3. 確率質量関数と確率密度関数
離散型確率変数では、確率質量関数を使います。
確率の総和は1です。
連続型確率変数では、確率密度関数を使います。
連続型で重要なのは、密度 $f(x)$ そのものは確率ではないという点です。確率は区間の面積で求めます。
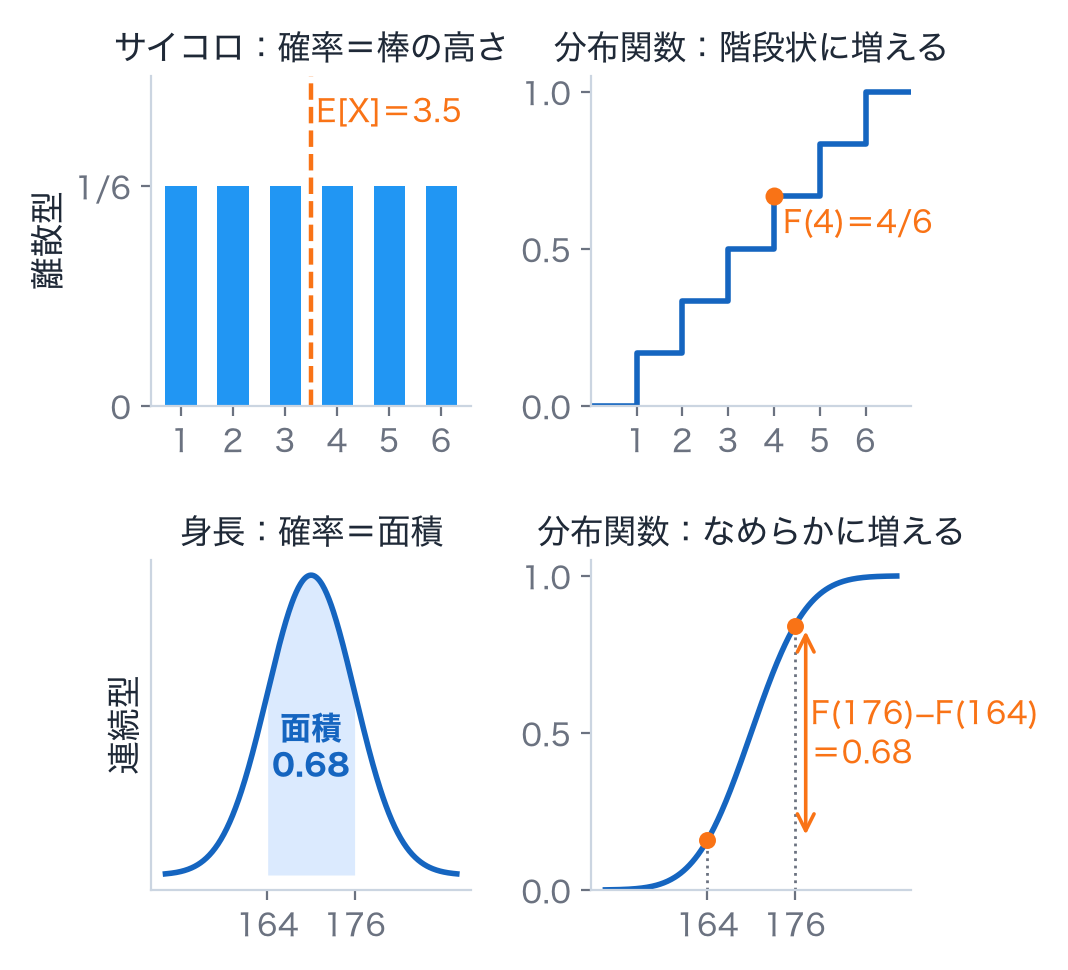
[図1] 離散型(サイコロ)は棒の高さが確率、連続型(身長)は曲線の下の面積が確率。分布関数はどちらも左から積み上げた確率
4. 分布関数と密度関数の関係
分布関数は、確率変数がある値以下になる確率です。
離散型でも連続型でも定義できます。
連続型では、分布関数を微分すると密度関数になります。
逆に、密度関数を積分すると分布関数になります。
| 関数 | 意味 | 覚え方 |
|---|---|---|
| PMF | 離散型で各値の確率 | 点ごとの確率 |
| 連続型で密度を表す | 面積で確率 | |
| CDF | $X\le x$ の累積確率 | 左からの累積 |
5. 期待値:確率変数の加重平均
期待値は、確率変数の平均的な位置を表します。離散型では、値とその確率を掛けて足します。
連続型では、密度関数を使って積分します。
期待値は、単なる「最も起こりやすい値」ではありません。確率で重み付けした平均です。
期待値は「長期平均」として読む
期待値は、1回の結果を当てる値ではありません。同じ確率的な試行を何度も繰り返したとき、平均がどこへ近づくかを表す値です。
サイコロの期待値は3.5ですが、1回のサイコロで3.5は出ません。それでも、何度も振った平均は3.5に近づきます。この感覚が、後の標本平均や大数の法則につながります。
期待値には線形性があります。
この性質は非常に重要です。複数の確率変数の和でも、期待値は足し算で扱えます($E[X+Y]=E[X]+E[Y]$ は、$X$ と $Y$ が独立でなくても成り立ちます)。
関連教材(青の統計学)
6. 分散:期待値からの散らばり
分散は、確率変数が期待値からどれくらい散らばるかを表します。
計算では、次の変形がよく使われます。
分散の性質として、定数倍と定数項の扱いを押さえましょう。
期待値では $b$ が残りますが、分散では定数項 $b$ は消えます。全員の点数に5点を足しても、ばらつきは変わらないからです。
| 変換 | 期待値 | 分散 |
|---|---|---|
| $aX+b$ | $aE(X)+b$ | $a^2Var(X)$ |
なぜ分散では係数が2乗になるのか
分散は、平均との差を2乗したものの平均です。$X$ を $a$ 倍すると、平均との差も $a$ 倍になります。その差を2乗するため、分散は $a^2$ 倍になります。
一方、$b$ を足す操作は分布全体を横にずらすだけです。平均との差は変わらないので、分散には影響しません。
7. モーメント、歪度、尖度
モーメントは、確率分布の形を表す量です。
$k$ 次の原点モーメントは次のように書けます。
| モーメント | 主な意味 |
|---|---|
| 1次 | 平均位置 |
| 2次 | 広がり、分散に関係 |
| 3次 | 歪度、左右非対称性(平均のまわりの3次モーメントを使う) |
| 4次 | 尖度、尾の厚さや尖り(平均のまわりの4次モーメントを使う) |
歪度は、分布の非対称性を表します。
尖度は、分布の尾の厚さや尖りを表します。
この定義では正規分布の尖度は3です。3を引いた値(超過尖度)を尖度と呼び、正規分布を0とする流儀もあるので、問題文の定義を確認します。
統計検定2級では、歪度と尖度は図や分布の形とセットで問われることがあります。細かな導出よりも、右に裾が長いと歪度が正、左に裾が長いと歪度が負、という直感を押さえましょう。
関連教材(青の統計学)
8. 試験での典型問題
この章の内容は、分布の問題、推定の問題、検定の問題の土台です。
- 離散型と連続型で期待値の式を選ぶ問題
- $E(aX+b)$ と $Var(aX+b)$ の違いを問う問題
- $E[X^2]-E[X]^2$ を使って分散を計算する問題
- CDFとPDFの関係を問う問題
- 歪度と尖度を分布の形から読み取る問題
特に、期待値と分散の変換は、二項分布、標本平均、回帰の誤差項など多くの章で再登場します。
試験で問われやすいポイント
- 離散型は和、連続型は積分で確率や期待値を求める
- 連続型では一点の確率ではなく区間の面積を見る
- 分布関数は $F(x)=P(X\le x)$
- 連続型では $f(x)=dF(x)/dx$
- 期待値は線形性を持つ
- 分散では係数が2乗になり、定数項は影響しない
- 歪度は非対称性、尖度は尾の厚さや尖りを表す
この章のあとに解きたい演習
この章で扱った概念の問題です。本文を読んだら、解いて理解を確かめましょう。